Pitta nympha¶
팔색조 Pitta nympha는 장거리 이동성 명금류로, 다층 구조의 활엽수림 번식지를 선호합니다. 본 예제 자료는 출판된 현장 연구 — Lee et al. (2025, Global Ecology and Conservation 64:e03939) — 의 자료를 재현한 것으로, 경상남도 거제도(거제시)의 둥지 위치를 조사하고 maxnet R(ENMeval 2.0)으로 Maxent 모델을 학습한 사례입니다. 같은 자료를 QMaxent로 재실행하는 데에는 두 가지 목적이 있습니다.
- 소규모 실측 자료(47개 둥지)에 대한 워크 예제: 연속형 지형 변수와 범주형 임상 변수가 혼합된 현실적 자료.
- maxent.jar와의 구현 간 비교: 같은 입력을 두 프로그램에 주고 두 설정(β 1, Lee et al. 설정 β 4)에서 학습 AUC, 예측값, 변수 중요도 순위를 비교한 결과를 직접 확인해 볼 수 있습니다(§ 7).
1. 자료¶
Lee et al. (2025) Table 1의 변수 10개를 사용합니다.
| 레이어 | 타입 | 설명 |
|---|---|---|
pitta_nympha_occurrence |
벡터 점 | 거제도의 둥지 위치 47점 |
TWI |
연속 래스터 | 지형 습윤 지수 |
TIN |
연속 래스터 | 고도 |
ASPECT |
연속 래스터 | 사면 방향 (°) |
SLOPE |
연속 래스터 | 사면 경사 (°) |
SMI |
연속 래스터 | 토양 수분 지수 |
DBH |
연속 래스터 | 평균 흉고직경 |
HEIGHT |
연속 래스터 | 평균 수관 높이 |
AGE |
범주형 래스터 | 영급(1–4) |
CANOPY_COVER |
연속 래스터 | 수관 폐쇄도(%) |
SPECIES |
범주형 래스터 | 우점수종(코드) |
10개 래스터 전부 동일 격자(EPSG:5186 KGD2002 중부원점, 10 m × 10 m)를 공유합니다. 본 자료는 실제 현장 조사 자료로, 플러그인의 Example Dataset Downloader에는 포함되어 있지 않습니다. 원고 교신저자가 자료의 원본을 보유하고 있습니다(연락: bhyu@knps.or.kr).
2. 자료 적재¶
① Data 탭에서 pitta_nympha_occurrence를 Presence Points Layer
드롭다운에서 선택하고(47점), 프로젝트에서 10개 래스터를 일괄 추가한 뒤,
AGE와 SPECIES를 [categorical]로 표시합니다. Check Raster
Consistency를 누릅니다.
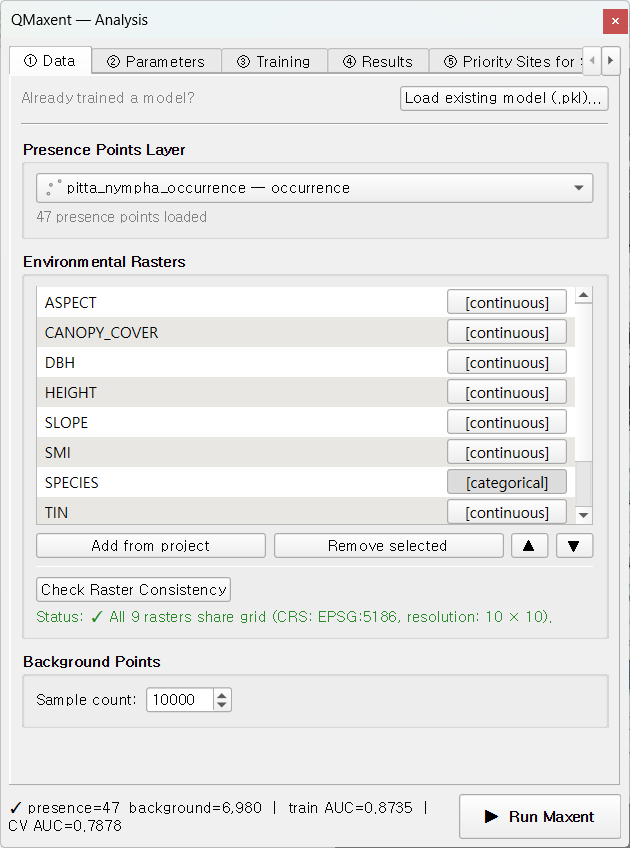
상태 줄에
✓ All 10 rasters share grid (CRS: EPSG:5186, resolution: 10 × 10)
이 표시됩니다. 출현점은 거제도 중부 산림 능선에 집중됩니다.
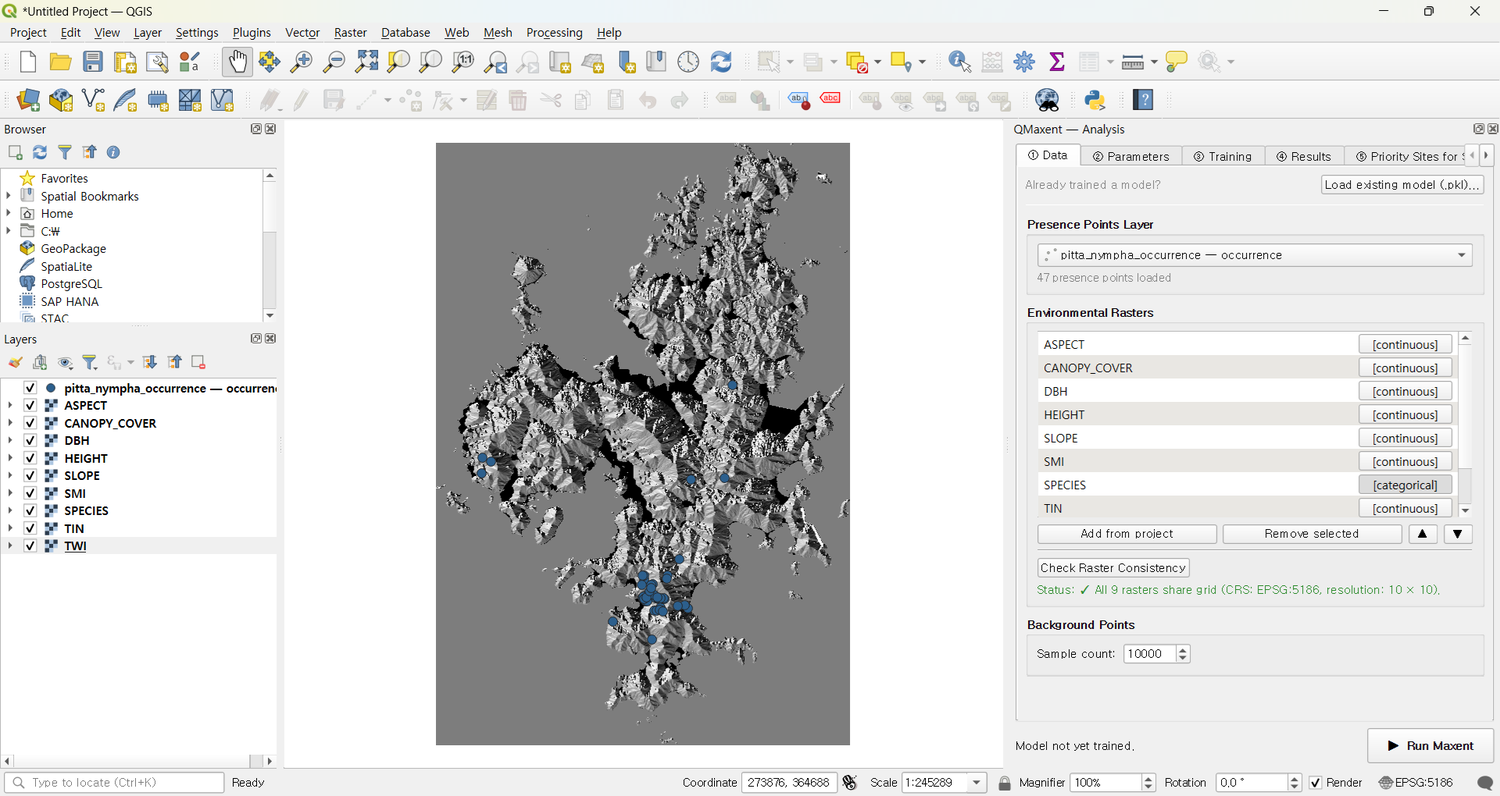
3. Lee et al. 설정 매개변수¶
② Parameters 탭에서 Feature Types를 수동 선택으로 전환하고 Linear, Quadratic, Hinge만 체크합니다(Product, Threshold 해제). 출현점이 47개이므로 자동 규칙을 써도 같은 LQH가 선택됩니다. Regularization multiplier = 4.00으로 설정. Spatial evaluation은 Random K-Fold (Phillips 2006), Folds = 10, seed = 42. Jackknife와 Permutation importance(반복 10회, 평가 자료 학습 자료 (maxent.jar 방식))는 활성화 유지.
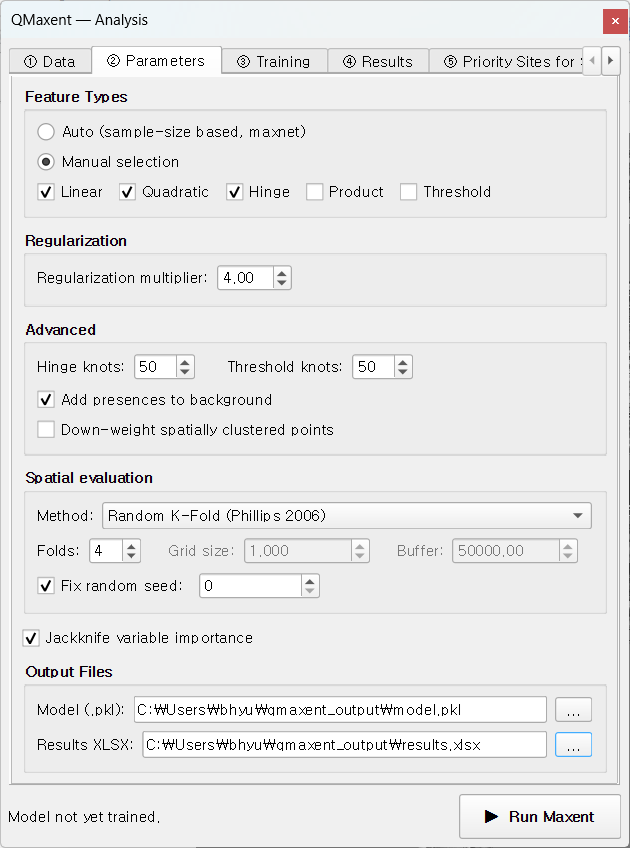
이 설정(LQH, β 4)은 Lee et al. (2025)에서 ENMeval이 최적으로 선택한 구성입니다. Lee et al.은 최종 모델을 75/25 무작위 분할 10회로 평가했으므로, 여기서 쓰는 Random 10-fold 교차검증과 평가 방식은 다릅니다. 두 방식의 결과는 § 7에 정리했습니다.
4. 학습¶
▶ Run Maxent를 누릅니다. Training 탭이 약 20초 만에 완료됩니다.
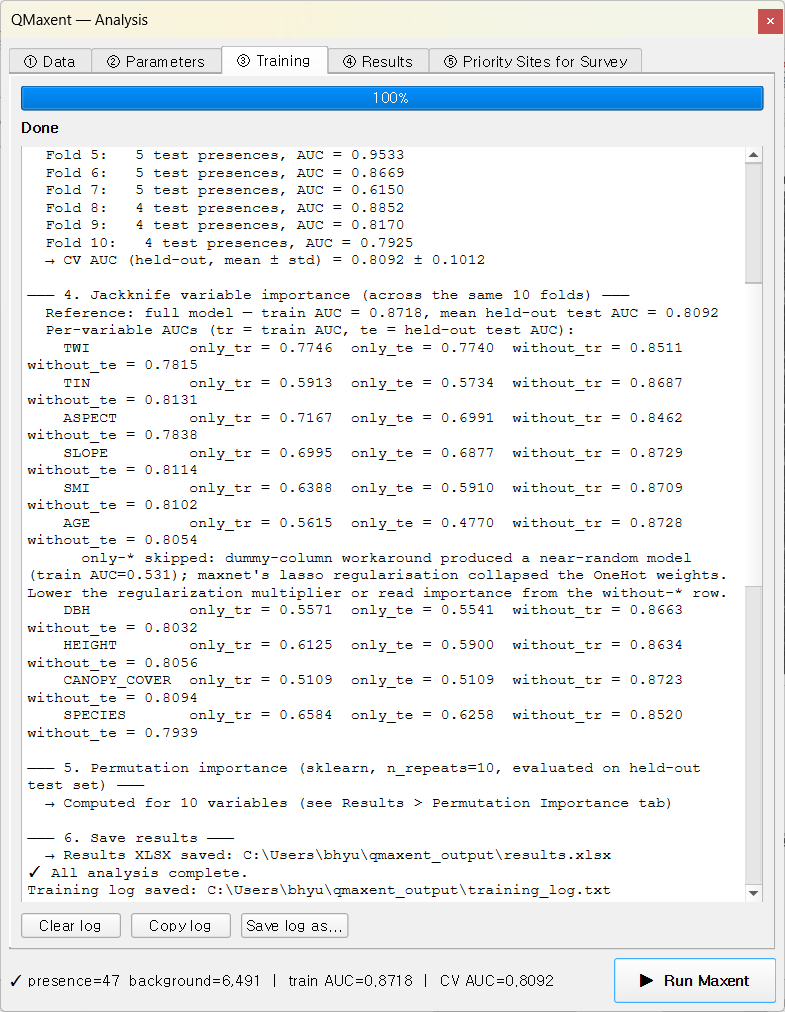
하단 상태 줄에 출현점 수, 배경점 수, 학습 AUC, CV AUC가 표시됩니다.
- Full-data model: 학습 AUC가 로그와 상태 줄에 표시되며, 모델과 함께
모델 카드(
model_model_card.json)와 계수표(model_coefficients.csv)가 저장됩니다. - Cross-validation: Random K-Fold n=10, seed=42. v0.2.0의 평균 ± 표준편차는 0.812 ± 0.110 입니다. fold별 AUC의 변동이 Bradypus나 Ariolimax보다 큰데, 현장 조사 자료의 작은 표본(fold당 4–5개 검증 출현점)이 만드는 전형적 양상입니다.
화면의 수치
위 화면은 v0.1.x에서 캡처한 것이라 상태 줄의 배경점 수와 AUC가 본문의 v0.2.0 값과 다릅니다.
범주형 변수가 있을 때의 Jackknife¶
로그에 다른 두 예제에는 없는 진단 메시지가 표시될 수 있습니다.
only-*skipped: dummy-column workaround produced a near-random model (train AUC = 0.531); maxnet's lasso regularisation collapsed the OneHot weights. Lower the regularization multiplier or read importance from thewithout-*row.
AGE와 SPECIES는 본 스택의 범주형 변수입니다. only-this-variable
잭나이프 패스에서 범주형 변수는 one-hot 인코딩되어야 하는데, β = 4의 L1
lasso 페널티가 OneHot 가중치를 거의 0으로 압축해 버릴 수 있습니다. 그러면
Maxent가 평가에 사용할 정보가 남지 않습니다. QMaxent는 이 collapse를 감지해
해당 only-* 행을 건너뛰고 사용자에게 알립니다. without-* 행은 여전히
정보적이며, 해당 변수의 증분 기여도를 읽는 올바른 위치입니다.
이는 Merow et al. 2013이 기술한 과대 정규화 실패
모드의 예시입니다. β = 1 구성에서는 의미 있는 only-* AUC가
회복됩니다(본 가이드에는 표시하지 않음).
5. 변수 행동¶
반응 곡선 — ASPECT¶
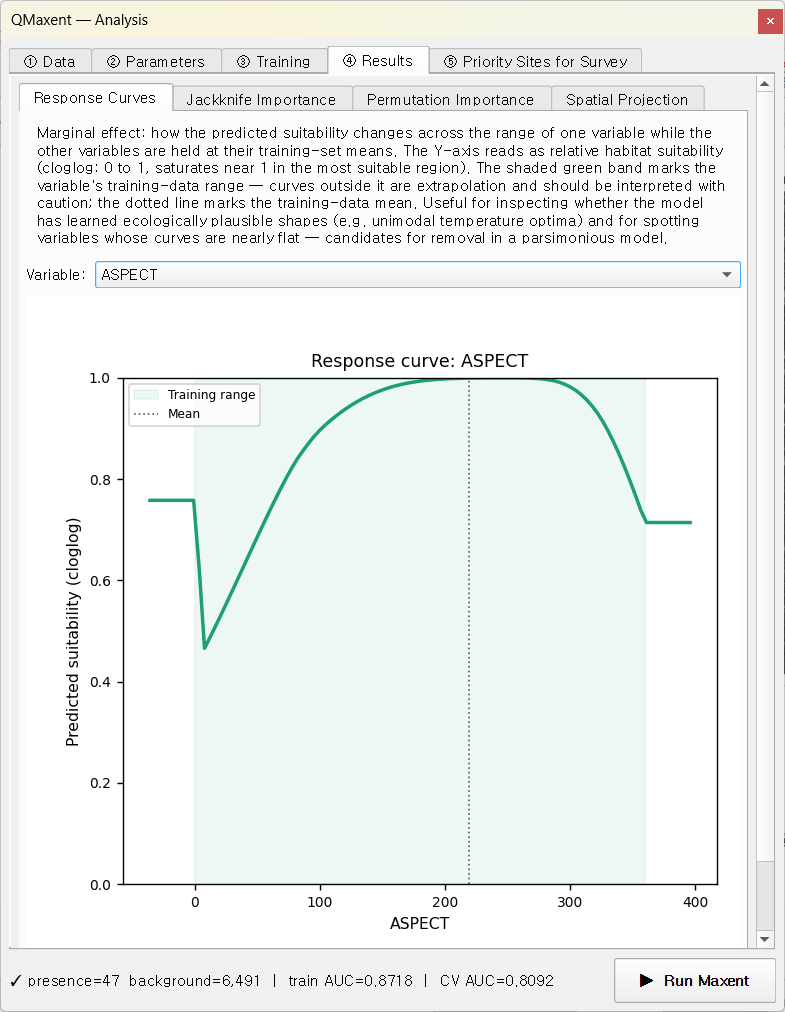
모델은 북향(약 270°–360°)에 가장 높은 적합도를 할당합니다 — 능선 어깨의 음지·저온·고습 미기후를 선호한다는 팔색조의 알려진 생태에 부합합니다.
Jackknife 중요도¶
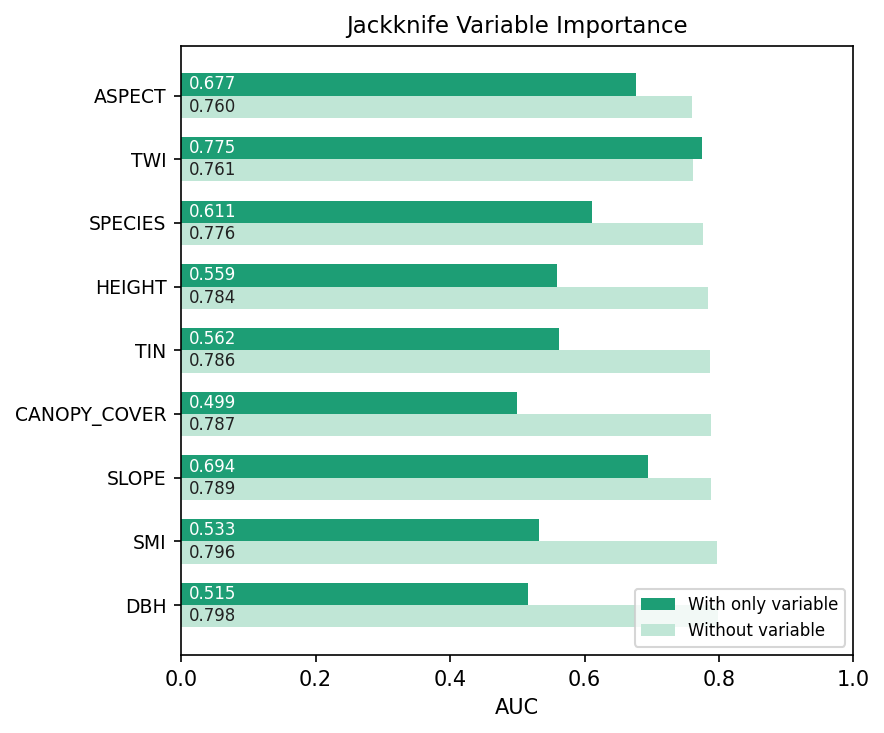
ASPECT, TWI, SPECIES가 가장 강한 without-row 신호를 가집니다 —
제거 시 손실이 가장 큰 변수들. § 4에 설명한 이유로 범주형 변수의
only-* 막대는 생략될 수 있으므로, 범주형 변수는 without-* 순위로
해석하는 것이 정직합니다.
Permutation 중요도¶
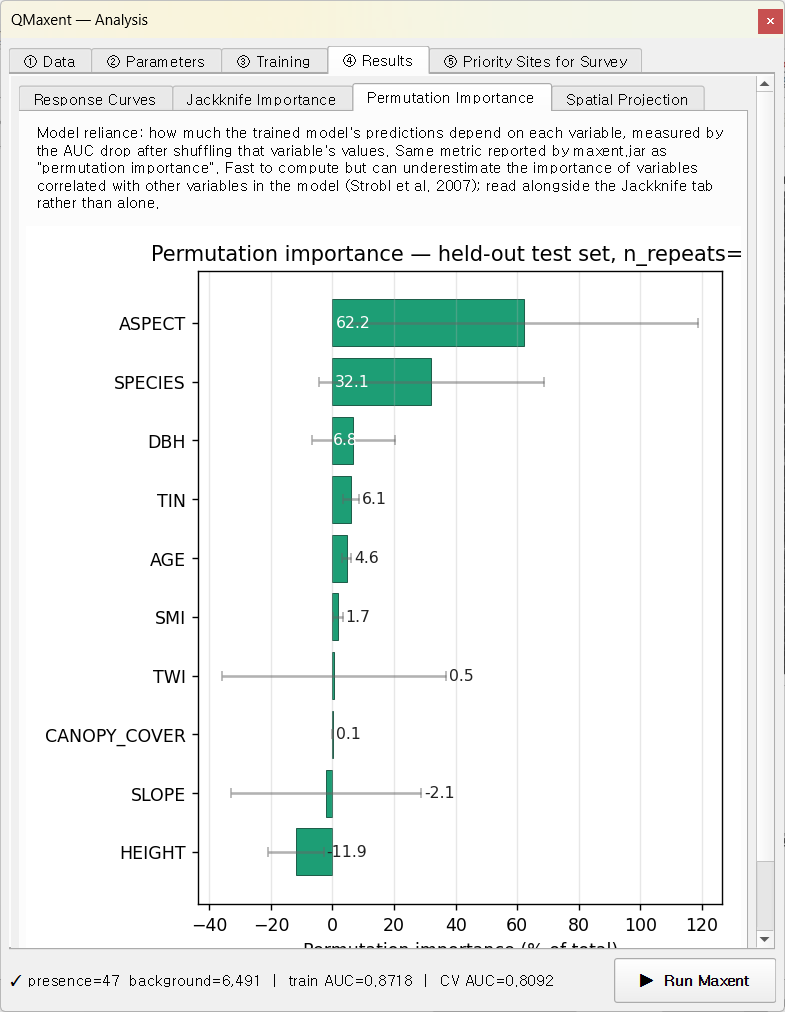
Permutation 패스는 재학습 없이 각 변수의 값을 섞어 AUC 하락을 재므로, 범주형 변수를 포함한 10개 변수 모두 직접 비교 가능한 percentage를 얻습니다. 평가 자료를 학습 자료 (maxent.jar 방식) 로 두면 maxent.jar와 같은 정의로 계산되어 두 프로그램의 순위를 바로 비교할 수 있습니다.
6. 조사지점 선정¶
투영 후 ⑤ 조사지점 선정 → 고적합도 탐색 모드에서 거제도 영역에 대한 현장 출장 조사지점을 선정합니다. 설정은 다음과 같습니다.
- 샘플링 순서: 무작위
- 조사지점 수: 20
- 최소 적합도: 0.900 (래스터 최댓값의 0.9배로 자동 설정된 값)
- 기존 출현지로부터 최소 거리 (m): 1,000 (기존 둥지에서 1,000 m 이상)
- 지점 간 최소 거리 (m): 500
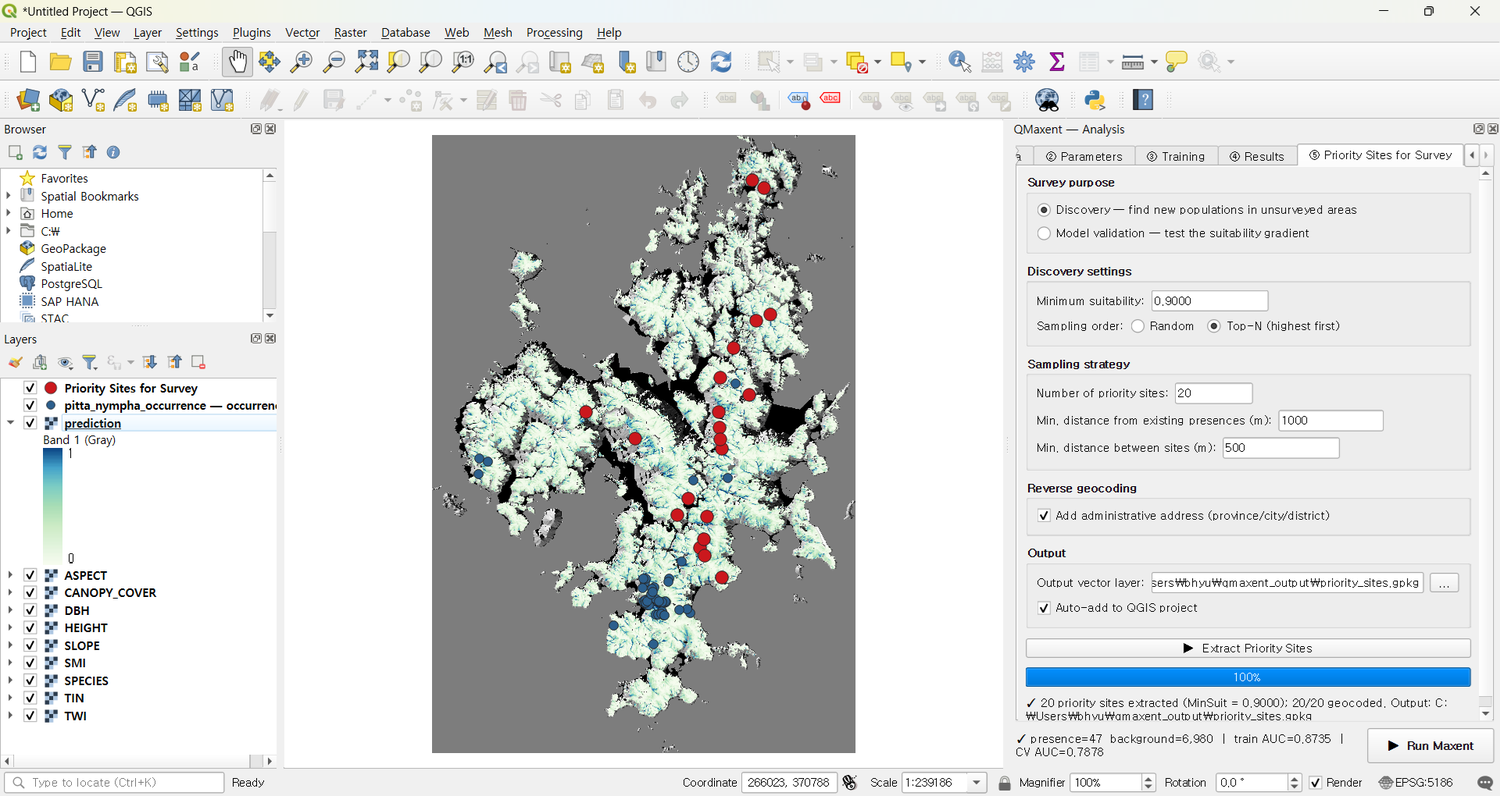
주소 언어 기본값인 현지 이름 에서는 한국어 행정구역 이름이 기록됩니다.
OpenStreetMap에 자료가 있는 한도 안에서 province(도), city_county(시군구),
district(이 지역에서는 읍/면/동 수준) 필드가 attribute table에 자동 부착되어,
모델 결과에서 현장 출장 계획까지 한 걸음에 연결됩니다.
7. maxent.jar 및 Lee et al. (2025)와의 비교 (v0.2.0)¶
maxent.jar v3.4.4와 QMaxent v0.2.0에 같은 입력(출현점 47개, QMaxent가 추출해 SWD 형식으로 내보낸 배경점 9,384개, LQH)을 주고 비교했습니다. 순열 중요도는 두 프로그램 모두 학습 자료에서 계산했습니다.
| 설정 | 학습 AUC (maxent.jar) | 학습 AUC (QMaxent) | 예측값 상관 r | 순열 중요도 순위 ρ |
|---|---|---|---|---|
| β 1 | 0.8795 | 0.8738 | 0.957 | 0.648 |
| β 4 (Lee et al. 설정) | 0.8520 | 0.8645 | 0.894 | 0.867 (p = 0.001) |
두 프로그램은 같은 입력에서 가깝게 일치하지만 소수 셋째 자리까지 같지는 않습니다. elapid의 scikit-learn 백엔드는 모든 피처에 같은 정규화 강도를 적용하고 maxent.jar는 피처 클래스별로 정규화하기 때문입니다.
Lee et al. (2025)의 최종 모델 방식(LQH, β 4, 75/25 무작위 분할 10회)으로 QMaxent를 실행하면, 순열 중요도 순위와 Lee et al. Table 4의 순위 사이 Spearman ρ = 0.830 입니다. 상위 3개 변수(TWI, ASPECT, SPECIES)는 maxent.jar, QMaxent, Lee et al. 모두 같습니다.
QMaxent의 교차검증 AUC(평균 ± 표준편차)는 분할 방식에 따라 다음과 같습니다.
| β | Random 10-fold | Geographic 5-fold |
|---|---|---|
| 1 | 0.805 ± 0.108 | 0.713 ± 0.138 |
| 4 | 0.812 ± 0.110 | 0.739 ± 0.134 |
공간적으로 분리된 Geographic 5-fold의 AUC가 Random 10-fold보다 낮은 것은
Roberts et al. 2017이 지적한 무작위 분할의 낙관적 편향과
일치합니다. 이 비교의 기준값은 tests/fixtures/pitta_golden_values.json 에
기록되어 있습니다.
8. 이 예제가 시연하는 것¶
- 소규모 실측 자료(47개 출현점, 10개 공변량, 현실적 공간 규모) 에서의 워크플로우.
- 범주형 변수 처리(AGE, SPECIES)와 과대 정규화 시 OneHot collapse 진단 메시지.
- Lee et al. 설정(LQH, β 4) 과 β 1에서 maxent.jar와 수치를 비교하는 방법.
- 이전 예제와 다른 좁은 의미의 조사지점 선정 활용 — 대륙 규모의 신규 발견이 아닌 알려진 부분 개체군의 표적 재조사.